只需声明一次,始终保持一致:隆重推出 Bot Preference Sync


我们始终致力于满足客户的多样化需求。有些客户希望优化内容发现,另一些客户则希望以最严格的安全策略保护内容。在这些不同策略中,有多种方法可以缓解机器人流量: 有些机制仅声明您的意愿,默认爬网程序出于善意;另一些则通过 Bot Management 解决方案直接阻止,从根本上锁定内容访问。
我们深知,在网站上维护多重防护层十分繁琐。例如,可能出现这样的情况:您的 robots.txt 声明某个爬网程序被禁止访问您的网站,但实际的执行规则并未将其阻止。当您声明的意愿与实际执行的规则相悖时,部分爬网程序可能将此视为无视您意愿或绕过规则的依据。
几年前,Cloudflare 推出了一种更便捷的方式,允许网站所有者禁止 AI 训练抓取,同时兼顾两个防护层:一个受管理的 robots.txt 值,明确告知固定名单中的主要训练类爬网程序不得抓取您的内容进行训练;以及针对训练类爬网程序的边缘执行阻止。2026 年 7 月 1 日,我们进一步推出了更灵活的选项,让您能够分别管理搜索、代理及训练类 AI 流量的访问策略。
今天,我们正式宣布推出 Bot Preference Sync,面向从免费计划到企业计划的所有客户开放。Bot Preference Sync 能够根据您在 AI 机器人配置中的设置,自动更新 robots.txt 中的对应偏好,并可随时开启或关闭。不再为单一用例维护静态文件:我们将帮助您定制 robots.txt 文件,反映您针对不同 AI 机器人类别所做的配置。
互联网面临的新议题
多年来,这一领域最迫切的问题始终是:"我的内容是否在未经许可的情况下被用于训练 AI 模型?"这是一个重要问题,且不会消失。与此同时,我们越来越多地听到关于可发现性与用户互动的议题:当有人向 AI 助手提问而我的网站能够解答时,我该如何出现在搜索结果中?有多少流量来自 AI 爬网程序,有多少流量来自真实用户?哪些内容真正带来了引荐流量,其价值几何?
答案因商业模式而异。可发现性与用户互动是所有希望在现代网络中立足的企业的核心关切,但其转化路径各异:电商网站可能希望所有内容都被抓取并用于训练,以便当购物者向聊天机器人询问"小户型最佳沙发"时,其产品能够出现在推荐结果中。而依靠广告变现的媒体发布商则可能恰恰相反:希望保留在能为页面带来读者的搜索索引中,同时让文章内容远离模型训练——并且至关重要的是,能够核实其内容确实未被未经授权地使用。
关键在于,没有唯一正确答案。您的管控策略应当反映您的业务战略,这也是我们一直致力于为您提供全链路可见性与选择权的原因。Bot Preference Sync 将这些层面融为一体,让您设置的偏好就是您对外发布的偏好。
透明度的呼声
2026 年 7 月 1 日,我们提出:混合用途爬网程序——即“以单一用户代理身份,混合执行搜索、智能体使用和训练任务的机器人”——使网站所有者处于不利地位,因为这让用户难以区分自己想要什么和不想要什么。这一判断至今未变,我们对网站所有者透明度的立场也未曾动摇。
但实现透明度的方式不止一种。我们希望奖励那些明确声明身份和数据使用方式的运营商。为了进行机器人验证,同时执行搜索和训练的机器人所有者需要提供额外信息,以免在启用“禁止训练”时遭到屏蔽。具体要求如下:
- 机器人必须通过某种机制,遵守 robots.txt 中的"禁止训练"偏好
- 为网站所有者提供退出 AI 摘要的方式
- 提供哪些页面被用于训练的 URL 级别可见性,以及搜索结果的相关指标,让网站所有者能够了解其内容在搜索和训练中的使用情况
- 能够公开证明:禁止训练不会损害其传统搜索结果排名
Cloudflare Radar 的 AI 机器人透明度部分公开追踪符合上述标准的主流 AI 模型及服务提供商的机器人,其中包括遵循最佳实践的示例以及违反最佳实践的示例。未能提供透明度的爬网程序将不会获得"善意推定"——在您禁止训练时,它们仍将被阻止。换言之,这是将透明度作为准入门槛的一种方式。
Bot Preference Sync 详解
Bot Preference Sync 是一项新功能,能够让您的 robots.txt 始终与您在 Cloudflare 区域级别仪表板中为搜索、代理和训练类 AI 机器人所做的偏好设置保持同步。如果网站所有者已有 robots.txt 文件,Bot Preference Sync 添加的内容将附加到现有内容之前,原有的任何禁止指令均予以保留。
网站所有者无需再单独维护静态文件——Cloudflare 将根据您的配置生成或更新 robots.txt,使您向外界声明的内容与边缘执行的策略始终保持一致。
对于搜索和代理,我们在 7 月 1 日宣布的三个选项依然有效:允许、仅在投放广告的页面上阻止,或全站阻止。对于训练,我们进一步细化了阻止内容被用于模型训练的选项,推出禁止选项:
禁止:在 robots.txt 中写入“禁止训练”偏好,使采取额外透明度措施的合规混合用途爬网程序仍可访问您的内容用于搜索索引——因为这些爬网程序允许网站所有者直接核实其数据的使用方式。合规爬网程序将遵守 robots.txt 中的偏好,您在合规爬网程序中的搜索可见性不受影响。
以下面的示例为例:某网站所有者将 AI 机器人策略配置为"允许搜索、允许代理、禁止训练"。

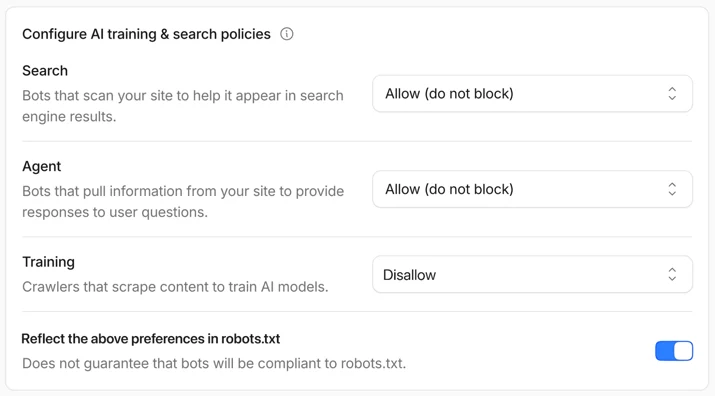
由于该示例网站已开启 Bot Preference Sync,其 robots.txt 将在开头附加类似如下内容(为示例起见,已做简化和匿名处理):
# BEGIN Cloudflare Bot Preference Sync

User-agent: TrainingBot1
User-agent: TrainingBot2
User-agent: TrainingBot3
User-agent: MixedUseBot-Extended
Disallow: /

...

# END Cloudflare Bot Preference Sync
我们将利用 BotBase 中追踪的机器人,定期更新当您选择阻止或禁止某类别时添加到 robots.txt 中的机器人列表。分类为搜索、智能体和训练的已验证机器人,可随时在我们的公开机器人目录中查看。
对于所有新客户,Bot Preference Sync 将默认开启,以便更轻松地管理体现同一策略的阻止设置和偏好设置。对于正在使用旧版受管理 robots.txt 功能的现有客户,我们将在 Bot Preference Sync 正式上线时提示您审查并确认偏好,以完成迁移。
部分客户可能希望或需要对偏好声明进行更精细的控制,例如希望为特定公司设置例外。由于 Bot Preference Sync 的设计目的是处理按类别制定的策略决策,而非逐条处理含复杂逻辑的自定义规则,因此它不会直接读取个别自定义规则。偏好设置更精细的客户,始终可以选择关闭用于设置组级别策略的同步功能,并自行定制 robots.txt 文件以匹配其自定义策略。
我们还针对发布商或依赖广告的网站进行了调整,为其提供与其他网站所有者不同的默认设置。我们为依赖广告变现、并希望广告位保留给真实访客的发布类网站创建了一个默认选项。此类客户在接入时可选择"我通过该域名上页面的广告进行变现",系统将自动将训练设置默认为禁止。(客户可随时更改此设置。)这样,您既能保留在搜索结果中的露出,又能让内容远离模型训练。
对于非发布商客户,新客户在接入域名时,默认不会添加任何阻止或禁止:选择权在您。您可以随时选择阻止搜索、智能体或训练流量,但初始状态不会代您添加任何阻止设置。
下一步计划
Bot Preference Sync 将在未来一周内向所有客户、所有计划开放。请关注我们的 Changelog 了解具体上线时间并留意仪表板(及收件箱)中的提示,以确认您的偏好设置!
这只是一项长期工作的开端。我们将继续与大型机器人运营商合作,确保在应对现有挑战(例如未经同意的训练抓取)和新兴议题(例如可发现性与用户互动)时不做妥协。所有这些努力的最终目标,是促进网站所有者提高透明度与增加掌控权。
